本节对应原书 PDF 第 232–248 页。定义、定理、公式、例题及其原解答逐字取自原书;解释性文字为 AI 通俗化改写;标有「解读」的引用块为 AI 补充的额外直觉。
这一节讲的是「一步套一步」的计数:要求出规模为 n 的答案,先把它和规模更小的答案挂上钩,写成一个等式,再想办法解出通项。这样的等式叫递推方程,它既是组合计数的重要工具,也是分析递归算法效率的标准手段——算法的运行时间往往本身就写成递推方程,解出来才知道算法到底快不快。
10.1.1 递推方程的定义及实例
定义 10.1 设序列 a_0,a_1,\cdots,a_n,\cdots,简记为 \{a_n\},一个把 a_n 与某些个 a_i(i<n) 联系起来的等式称作关于序列 \{a_n\} 的递推方程.
例 10.1 一个著名的数列称作 Fibonacci 数列,它源于一个有趣的故事.在一个岛上放了一对兔子,其中一只公兔,一只母兔.除了本月新出生的小兔外,假定每对兔子每个月都可以生出一对小兔,且新生的小兔也是一只公兔和一只母兔.如果兔子不会死去,也不会被运走,问 12 个月以后岛上有多少对兔子?用 f_n 表示第 n 个月初的兔子对数.那么在第 n-1 个月初已经在岛上的兔子仍旧生活在岛上,这些兔子有 f_{n-1} 对.除此以外,第 n-1 个月新增加的小兔对数恰好等于第 n-2 个月初在岛上的兔子对数 f_{n-2}.根据上述分析可以得到递推方程
这个递推方程的初值是 f_1=1,f_2=2.可以规定 f_0=1.数 f_0,f_1,\cdots,f_n,\cdots 称作 Fibonacci 数.
怎样由这个递推方程求得 f_n?这就是本节所要解决的问题.
解读:递推方程只是把「大问题」和「小问题」绑在一起,它本身还不是答案。f_n=f_{n-1}+f_{n-2} 谁都能写出来,但要算出 f_{12} 甚至 f_{100},还得把它解成只含 n 的显式表达式——这正是 10.1.2 节要做的事。
例 10.2 Hanoi 塔.
图 10.1 中有 A,B,C 3 根柱子,在 A 柱上放着 n 个圆盘(图中的 n=3),其中小圆盘放在大圆盘的上边.从 A 柱将这些圆盘移到 C 柱上去.把一个圆盘从一根柱子移到另一根柱子称作一次移动,在移动和放置时允许使用 B 柱,但不允许大圆盘放到小圆盘的上面.问把所有的圆盘从 A 柱移到 C 柱总计需要多少次移动?
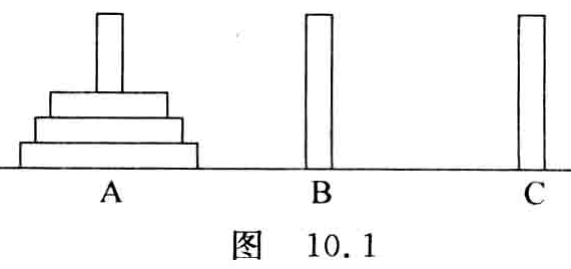
一种递归的求解方法是分三步解决这个问题.设使用这种方法移动 n 个盘子的总次数为 T(n).第一步使用同样的方法将 n-1 个盘子从 A 柱移到 B 柱,移动次数为 T(n-1);第二步利用 1 次移动将最下面的大盘子从 A 柱移到 C 柱;第三步还是用第一步的方法将 B 柱上的 n-1 个盘子移到 C 柱,移动次数为 T(n-1).因此得到递推方程
这个方程的初值是 T(1)=1.后面我们将证明这个方程的解是 T(n)=2^n-1.
这个问题就是著名的 Hanoi 塔问题,据说古代的僧侣按照这种方法移动 64 个金盘子,他们认为当 64 个金盘子全部移完以后,世界的末日就到了.让我们计算需要移动的时间.如果每秒钟移动 1 次,那么 64 个盘子需要
秒,大约是 5000 亿年.对于 Hanoi 塔问题,盘子的个数 n 代表问题规模,T(n) 代表求解规模为 n 的问题所做的基本运算次数,它代表了这种算法的效率,称为算法的时间复杂度.对于 Hanoi 塔问题,上述算法的 T(n) 是 n 的指数函数.不难看到,指数函数的值随着自变量 n 的增加呈爆炸性增长.对于比较大的 n,即使再提高 CPU 的速度,所占用的时间也是人们所不能承受的.正如上面的计算所显示的,即使 1 秒钟移动 1 亿次,64 个盘子也需要 5000 年的时间.因此在处理实际问题时,通常不能选择指数时间的算法.为了对算法的效率做出估计,求解递推方程是经常使用的方法.
解读:Hanoi 塔的递推式里系数是 2,因为除了中间那一次移动,n-1 个盘子要被整体搬运两次;每多一个盘子,工作量就翻一倍,所以解必然是指数量级。这类方程不需要精确解也能看出「规模稍大就算不动」。
例 10.3 一个编码系统用八进制数字对信息编码,一个码字是有效的当且仅当含有偶数个 7,求 n 位长的有效码字有多少个?
解 设所求的 n 位长的有效码字为 a_n 个,可以由长为 n-1 的八进制序列构成码字.如果长为 n-1 的八进制序列含有偶数个 7,那么在这个序列后面加上除了 7 以外的其他八进制数字,即加上 0,1,\cdots,或者 6,就得到所要求的码字;这种码字个数是 7a_{n-1}.如果长为 n-1 的八进制序列含有奇数个 7,这种序列有 8^{n-1}-a_{n-1} 个.对于其中的任何一个序列,在它后面加上 7 就得到所要求的码字,这种码字个数是 8^{n-1}-a_{n-1}.根据加法法则得到递推方程
经过整理得
这个递推方程的解是 a_n=(6^n+8^n)/2.这个解是怎样求出的?这正是需要解决的问题.
解读:例 10.3 的推导用了一个容易漏掉的技巧——按「末尾一位加什么」来分类。若前 n-1 位已有偶数个 7,末位只要不填 7 就仍然有效(7 种填法);若前 n-1 位有奇数个 7,末位必须填 7 才有效(1 种填法)。两类的个数相加,就得到方程。
例 10.4 在计算机中经常需要对数据进行排序,下面给出两种排序算法,试确定哪种排序算法在最坏情况下的时间复杂度比较低.为了简单起见,不妨设输入是 n 个不同的数构成的数组,其中 n=2^k,k 为正整数.
顺序插入排序算法.假设前 i-1 个数已经排好,从第 i-1 个数开始,从后向前,顺序将已经排好的数与第 i 个数进行比较,直到找到第 i 个数应该放置的适当位置,然后插入第 i 个数.算法开始时 i 等于 2,每当上述过程完成后 i 增加 1,直到 i=n 的过程完成为止.
设 W(n) 表示顺序插入算法在最坏情况下所做的比较次数.如果 n-1 个数已经排好,为插入第 n 个数,最坏情况下需要将它与前 n-1 个数中的每一个都进行 1 次比较,因此得到递推方程
通过求解可以得到 W(n)=\frac{1}{2}n(n-1)=O(n^2).
例 10.4(续)二分归并算法.将被排序的数组分成相等的两个子数组,然后使用同样的算法对两个子数组分别排序,最后将两个排好序的子数组归并成一个数组.例如对 8 个数的数组 L 进行排序,先将 L 划分成 L[1..4] 和 L[5..8] 两个子数组,然后分别对这两个子数组进行排序,子数组的排序方法与原来数组的方法一样,以 L[1..4] 的排序为例,先将 L[1..4] 划分成 L[1..2] 和 L[3..4] 两个更小的子数组,分别对它们排序,然后进行归并.当对更小的子数组 L[1..2] 进行排序时,按照算法需要进一步划分.划分结果是 L[1] 和 L[2],每个只含有 1 个元素,不再需要排序.这时算法将停止递归调用并开始归并.对于其他的子问题,算法也同样处理.
设 W(n) 表示二分归并排序算法在最坏情况下所做的比较次数,根据上面的分析,对 n 个数进行二分归并排序在最坏情况下的比较次数满足如下递推方程
其中 n-1 表示归并两个 n/2 长的子数组所需要的最多的比较次数.具体做法如下:每次比较两个子数组的首元素,将较小的数拿走.当一个数组为空时不再进行比较,将剩余的数全部拿走,顺序放到已归并好的数后面.在最坏的情况下,经过 n-1 次比较之后,只剩下 1 个数,就是最大的那个数.求解上述递推方程得到 W(n)=O(n\log n).与顺序插入算法比较,显然二分归并算法的复杂度函数的阶比较低,因此,二分归并算法在最坏情况下比顺序插入算法效率更高.
解读:归并两个长度各为 n/2 的已排序子数组时,每比较一次就取走一个元素,只有最后一个元素是被「剩下来」直接搬走的,所以最坏情况下恰好比较 n-1 次,这就是方程里那个 n-1 的来源。它把「分成两半再合并」的代价与「排序两半」的代价分开记账,递归式才写得出来。
以上给出的实例都需要求解递推方程.下面分别讨论不同的求解方法.
10.1.2 常系数线性齐次递推方程的求解
常系数线性递推方程是一类常用的递推方程,可以用公式法求解。它长什么样,先看定义.
定义 10.2 设递推方程满足
其中 a_1,a_2,\cdots,a_k 为常数,a_k \neq 0,这个方程称为 k 阶常系数线性递推方程. b_0,b_1,\cdots,b_{k-1} 为 k 个初值.当 f(n)=0 时称这个递推方程为齐次方程.
前面几个例子里,Fibonacci 数、Hanoi 塔、编码问题、顺序插入排序的递推方程都是常系数线性的,其中只有 Fibonacci 数的那个是齐次的.
解读:定义 10.2 里的三个限定词各管一件事——「k 阶」说方程往回看了 k 步,「常系数」说 a_i 不随 n 变,「线性」说各项都是 H 的一次式且没有 H 之间的乘积。三者缺一,后面的特征方程方法就不再适用。
要说清楚齐次方程的解长什么样,得先把特征根这个概念立起来.
定义 10.3 给定常系数线性齐次递推方程如下:
方程 x^k - a_1x^{k-1} - \cdots - a_k = 0 称为该递推方程的特征方程,特征方程的根称为递推方程的特征根.
递推方程与它的特征根之间的联系,由下面这个定理给出.
定理 10.1 设 q 是非零复数,则 q^n 是递推方程 (10.2) 的解当且仅当 q 是它的特征根.
证明 q^n 是递推方程的解
定理 10.2 设 h_1(n) 和 h_2(n) 是递推方程 (10.2) 的解,c_1,c_2 为任意常数,则 c_1h_1(n)+c_2h_2(n) 也是这个递推方程的解.
证明 将 c_1h_1(n)+c_2h_2(n) 代入该递推方程进行验证.
根据定理 10.1 和定理 10.2 不难得到以下推论:
推论 若 q_1,q_2,\cdots,q_k 是递推方程 (10.2) 的特征根,则 c_1q_1^n+c_2q_2^n+\cdots+c_kq_k^n 是该递推方程的解,其中 c_1,c_2,\cdots,c_k 是任意常数.
解读:定理 10.2 说的是「解可以线性叠加」。它之所以成立,是因为方程左边对 H 是线性的:把 c_1h_1+c_2h_2 代进去,c_1 和 c_2 可以提出来,剩下的两块各自为 0,于是整体为 0。齐次方程右边是 0,这一点是关键;非齐次方程就不再有这条性质。
这个推论只说明形如 c_1q_1^n+c_2q_2^n+\cdots+c_kq_k^n 的式子都是解,并没有回答反过来的问题:方程的解是不是都长这个样子.为了把这件事说清楚,先定义通解.
定义 10.4 若对递推方程 (10.2) 的每个解 h(n) 都存在一组常数 c_1',c_2',\cdots,c_k' 使得
成立,则称 c_1q_1^n+c_2q_2^n+\cdots+c_kq_k^n 为该递推方程的通解.
当 k 个特征根彼此不等时,上面那个式子确实就是方程 (10.2) 的通解,这正是下面定理的内容.
定理 10.3 设 q_1,q_2,\cdots,q_k 是递推方程 (10.2) 不等的特征根,则 H(n)=c_1q_1^n+c_2q_2^n+\cdots+c_kq_k^n 为该递推方程的通解.
证明 根据前面的推论知道 H(n) 是解,下面证明这个解是通解.设 h(n) 是递推方程 (10.2) 的任意一个解,h(0),h(1),\cdots,h(k-1) 由初值 b_0,b_1,\cdots,b_{k-1} 唯一确定.将初值代入得到以下线性方程组.
如果这个方程组有唯一解 c_1',c_2',\cdots,c_k',那么说明 h(n)=c_1'q_1^n+c_2'q_2^n+\cdots+c_k'q_k^n,从而证明了 H(n) 是递推方程的通解.由于上述方程组的系数行列式是范德蒙行列式 \prod\limits_{1 \leqslant i<j \leqslant k}(q_j-q_i),当 q_i \neq q_j 时,这个行列式不等于 0,因此线性方程组有唯一解.
解读:「通解」这个词在这里是有严格含义的:不是「一族解」,而是「能覆盖所有解的那一族」。定理 10.3 用范德蒙行列式不为零来保证 k 个初值条件能唯一确定 k 个常数,这一步正是「覆盖所有解」的凭据。
例 10.5 求解 Fibonacci 数列的递推方程.
解 递推方程是 f_n = f_{n-1} + f_{n-2},初值是 f_0=1,f_1=1.
特征方程是 x^2 - x - 1 = 0,求解得到特征根为 \dfrac{1+\sqrt{5}}{2},\dfrac{1-\sqrt{5}}{2}.因此,递推方程的通解为
代入初值 f_0=1,f_1=1,得
解得 c_1=\dfrac{1}{\sqrt{5}}\dfrac{1+\sqrt{5}}{2},c_2=-\dfrac{1}{\sqrt{5}}\dfrac{1-\sqrt{5}}{2},从而得到递推方程的解为
上面这套办法默认特征根互不相同.一旦出现重根,同一个重根对应的那些 q_i^n 会被归并成一项,可用的自由常数就少了;这时把通解代入初值,得到的方程组里方程个数会多于未知数个数,很可能无解.
解读:重根为什么不能照搬单根的做法?因为 q^n 与 q^n 本身线性相关,写 c_1q^n+c_2q^n 其实只有一个自由常数,k 个初值就凑不齐 k 个独立常数。补上 nq^n,n^2q^n,\cdots 这些乘了 n 幂的项,才能重新凑够线性无关的解的个数。
例 10.6 考虑递推方程
它的特征根是 2,为二重根,按照上面的方法得到通解
代入初值得到线性方程组
这个方程组无解.解决这个问题的方法是必须使用线性无关的解来构造通解,可以观察出 n2^n 是一个解,且与 2^n 线性无关.因此通解可以设为
把这个通解代入初值时得到 c_1=0,c_2=1/2,从而得到原递推方程的解是 H(n)=n2^{n-1}.
重根情形该怎么处理,例 10.6 已经示范了普遍做法.证明从略,结论由定理 10.4 给出.
定理 10.4 设 q_1,q_2,\cdots,q_t 是递推方程 (10.2) 的不相等的特征根,且 q_i 的重数为 e_i,其中 i=1,2,\cdots,t.令
那么该递推方程的通解是
例 10.7 求解以下递推方程
解 特征方程 x^4+x^3-3x^2-5x-2=0,特征根是 -1,-1,-1,2,通解为
其中待定常数满足以下方程组
解得 c_1=\dfrac{7}{9},c_2=-\dfrac{1}{3},c_3=0,c_4=\dfrac{2}{9}.原方程的解为
10.1.3 常系数线性非齐次递推方程的求解
常系数线性非齐次递推方程的标准形是
其中 n \geqslant k,a_k \neq 0,f(n) \neq 0.
要解这样的方程,先得弄清它的通解由哪些部分组成.
定理 10.5 设 \overline{H(n)} 是对应的齐次方程 (10.2) 的通解,H^*(n) 是方程 (10.3) 的一个特解,则
是递推方程 (10.3) 的通解.
证明 首先证明 H(n) 是递推方程 (10.3) 的解,将 H(n) 代入该递推方程得
因此 H(n) 是递推方程 (10.3) 的解.下面证明这个解是通解.
设 h(n) 是解,为证 H(n) 为通解,只需证明 h(n) 可以表示为对应齐次方程的一个解与特解 H^*(n) 之和.因为 h(n) 与 H^*(n) 都是递推方程 (10.3) 的解,因此
将以上两个式子相减得
这说明 h(n) - H^*(n) 是对应齐次方程的一个解,换句话说,h(n) 是对应齐次方程的一个解与特解 H^*(n) 之和.
解读:非齐次的通解 = 齐次通解 + 一个特解,这个结构与线性代数的非齐次线性方程组完全一致。原因是「两个非齐次解之差」必是齐次解,所以任意一个非齐次解都可以写成「某个固定特解 + 齐次解」。这也说明求特解时不必求全部,只要能凑出一个就够了。
定理 10.5 把非齐次方程的通解拆成了两块:对应的齐次方程的通解,加上一个特解.前一块有现成公式,所以剩下的活就是找一个特解,而特解的样子由 f(n) 决定.做法是先照 f(n) 的形式写出特解的表达式,再用待定系数法把其中的系数定下来.下面就几种常见的 f(n) 分别讨论.
1. 如果 f(n) 为 n 的 t 次多项式,那么特解一般也为 n 的 t 次多项式
先看几个例子.
例 10.8 找出下述递推方程的通解:
解 设 a_n^* = P_1n^2 + P_2n + P_3,代入递推方程得
整理得
从而得到线性方程组
解得 P_1=-2,P_2=-8,P_3=-12,而对应的齐次方程的通解是 c2^n,因此原方程的通解为
解读:待定系数法设特解时,形式上照着 f(n) 抄一遍通常就行;唯一会翻车的情形是 f(n) 里出现的那个「底」本身就是特征根——此时所设特解会被齐次解「吃掉」,必须再乘一个 n 才能摆脱抵消。例 10.9 与例 10.11 分别展示了这两种翻车与补救。
照上面的经验,f(n) 是多项式时就把特解也设成同次多项式.不过有一条例外:如果 1 是方程的特征根,这么设会出问题,看下面的例子.
例 10.9 求解例 10.4 关于顺序插入排序算法的递推方程
解 根据上面的分析,应该设特解为 W^*(n)=P_1n+P_2,将它代入递推方程,得
化简得 P_1 = n-1,左边是 n 的 0 次多项式,右边是 n 的 1 次多项式.没有常数 P_1 能够使它成立.原因在于:如果特征根是 1,当把特解代入方程后,在等式左边所设特解的最高次项和常数项都被抵消了.为了保证等式两边的多项式的次数相等,必须将特解的次数提高.不妨设特解为 W^*(n)=P_1n^2+P_2n,代入递推方程得
化简得
解得 P_1=1/2,P_2=-1/2.通解为
代入初值 W(1)=0,得 c=0,最终得到 W(n)=n(n-1)/2.这说明 W(n)=O(n^2).
例 10.10 Hanoi 塔问题的递推方程是
设特解为 H^*(n)=P,代入原方程得 P=2P+1,因此 P=-1.从而得到递推方程的通解是
代入初值 H(1)=1,得 c=1,解为 H(n)=2^n-1.
2. f(n) 为指数函数 A\beta^n,这里的 A 代表某个常数
(1)若 \beta 不是特征根,则特解为 P\beta^n,其中 P 为待定系数.
例 10.11 求解例 10.3 中关于编码系统的递推方程
解 设特解是 a_n^* = P8^n,代入递推方程得
解得 P=1/2.因此原递推方程的通解是
代入初值可得 c=1/2.从而得到递推方程的解是
(2)若 \beta 是 e 重特征根,则特解为 Pn^e\beta^n.
例 10.12 求递推方程 H(n)-5H(n-1)+6H(n-2)=2^n 的特解.
解 2 为特征根,因此令特解 H^*(n)=Pn2^n,代入得
化简并求解,得 P=-2,从而得到
10.1.4 递推方程的其他解法
解读:例 10.13 的关键一步是「令 b_n=a_n^2」——原方程里 a_n 是带平方的,看上去不像线性方程,但取平方这一步换元之后,关于 b_n 的方程立刻变成标准形式,解完再开方回去即可。换元法能用的前提是:变换后确实得到常系数线性方程,且反变换能把解送回来。
公式解法只对常系数线性递推方程有效.碰上别的形状,可以改用换元法或迭代归纳法.换元法的思路是把原来关于某个变元的方程,通过函数变换变成关于另一个变元的常系数线性方程,用公式法解出来之后,再做相反的变换换回去.
例 10.13 求解下述递推方程
解 令 b_n=a_n^2,代入原递推方程得
这是常系数线性递推方程,使用公式法解得
因此 a_n=\sqrt{5 \cdot 2^n - 1}.
例 10.14 求解与二分归并排序算法相关的递推方程
解 将 n=2^k 代入,该递推方程可以转换成关于变元 k 的常系数线性递推方程,即
该方程是常系数线性递推方程.其函数部分是 2^k-1,为指数函数 2^k 与多项式函数 -1 之和,因此特解也是指数函数与多项式函数的组合形式.由于 2 是特征根,令
将这个特解代入原方程,解得 P_1=P_2=1,从而得到
根据特解得到通解
代入初值,得 c=-1,因此得到原方程的解
将 k=\log n 代入得
这正好验证了 W(n)=O(n\log n).
接下来看迭代归纳法.所谓迭代,就是从原方程出发,反复用等式右边替换左边的函数项,一直替换到初值为止,再把累积出来的结果化简.为了确认没算错,通常还要把结果代回原方程验一遍.
下面用迭代归纳法求解例 10.14 的递推方程
解
对结果进行验证.把 n=1 代入上述公式得
符合初始条件.将结果代入原递推方程的右边得
这说明得到的解满足原来的递推方程.
解读:迭代归纳法就是把递推式一路往下代,代到初值为止,再回头把累积出来的和化简。它不依赖特征方程,代价是要能认出「代 k 次之后长什么样」这个规律;代完之后把结果代回原方程验一遍,是最省事的正确性保险。
迭代法一般只对一阶方程好使;二阶以上的方程,往往要先做一步变形化简.
例 10.15 用迭代归纳法求解错位排列问题的递推方程
解
变形为
从而得到一阶递推方程
不断迭代得
还有一种差消法,能把高阶递推方程降成一阶.下面这个例子来自快速排序在平均情况下的时间复杂度 T(n)(参见后面 13.3.1 节排序算法).它的右边依赖 T(n-1),T(n-2),\cdots,T(1),T(0) 全部前面的项,这类方程也叫全部历史递推方程.由于 T(0)=0,可以把这一项从方程里去掉,得到下面的方程.求解过程见例 10.16.
例 10.16
解 由原方程得到
将两个方程相减得到
化简得到
变形并迭代得到
上面公式中的 c 是某个常数,求和使用了积分作为近似结果,见图 10.2.根据积分有
因此得到原递推方程的解 T(n)=O(n\log n).
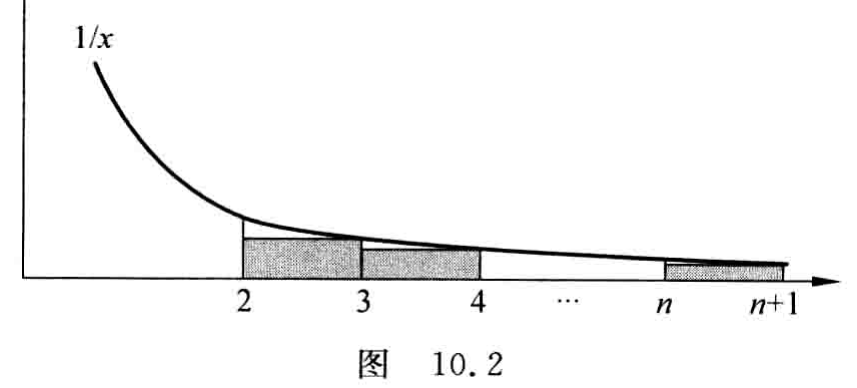
解读:差消法的动作是「把 n 换成 n-1 再写一遍,然后两式相减」。相减之后,右边那个含 n-1 项的大求和 \sum_{i=1}^{n-1}T(i) 被消掉,只剩下 T(n-1),高阶方程就降成一阶了。这里的和用定积分夹逼估计,是因为 1/n 这类调和和没有初等闭式。
很多递推方程求不出精确解,但可以估计出解的阶,这对算法分析来说已经够用.
迭代的过程还可以用递归树来直观地说明.仍以二分归并排序的递推方程为例:
递归树是一棵带权的二叉树,每个结点都有权.它一开始只有一个结点,权标记为 W(n).之后反复做同一件事:把树中权为函数的结点(如 W(n),W(n/2),W(n/4),\cdots)换成与这个函数相等的递推方程右部所对应的子树,直到树里不再有权为函数的结点.替换用的子树只有 2 层:树根是方程右部去掉函数项之后剩下的表达式,每片叶子是右部的一个函数项.第一步迭代把第 0 层唯一的结点 W(n) 换成「根为 n-1、两片树叶都是 W(n/2)」的子树,树由 1 层变成 2 层;第二步再把第 1 层权为 W(n/2) 的叶结点换成「根为 n/2-1、两片树叶都是 W(n/4)」的子树,树变成 3 层.如此进行下去,每迭代一次树就多一层,直到树叶都变成初值 1 为止,这个过程与图 10.3 画出的递归树完全对应.可以看到,迭代过程中整棵树的权之和始终不变,恒等于 W(n).
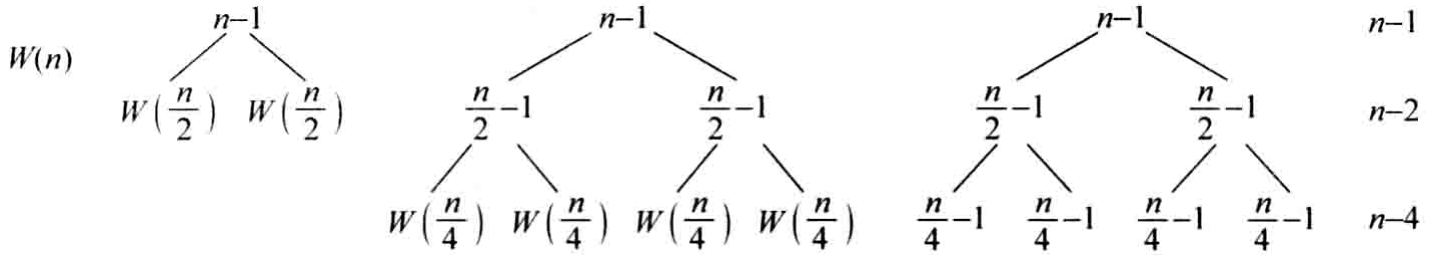
求最终这棵树的权之和,可以按层累加.递归树有 k 层,各层结点的值之和依次为
因此总和为
与前面用迭代法得到的结果一致.
解读:递归树把「迭代展开」画成了图形:每展开一层,就是把一个函数结点换成一棵小子树,整棵树的权和始终等于 W(n)。于是求 W(n) 变成数各层的权和——这比死记迭代规律更容易看出为什么每层权之和恰好是 n-1,n-2,n-4,\cdots。
如果只想要解的阶,还有一个更省事的办法:先猜一个函数作为解,代到方程两边比对.若两边最高阶的函数项一致,说明阶猜对了,否则换一个再试.
仍以例 10.16 的递推方程为例.
先设 T(n)=C 为常函数,代入原方程得
右边是一次函数而左边是常函数,右边阶更高,说明设小了.
改设 T(n)=cn,那么
由于 O(n) 中含有 n 的一次项(例如 an,a 是一个正的常数),两边最高次项仍不相等,右边还是偏高.
再试 T(n)=cn^2,代入得
这次右边最高次项比左边小,可见 T(n) 的阶介于 cn 与 cn^2 之间.
最后设 T(n)=cn\log n,代进去验算:
这里同样用积分作近似,见图 10.4,阴影部分的面积对应和式 \sum_{i=1}^{n-1}i\log i,故有
该积分算出来是
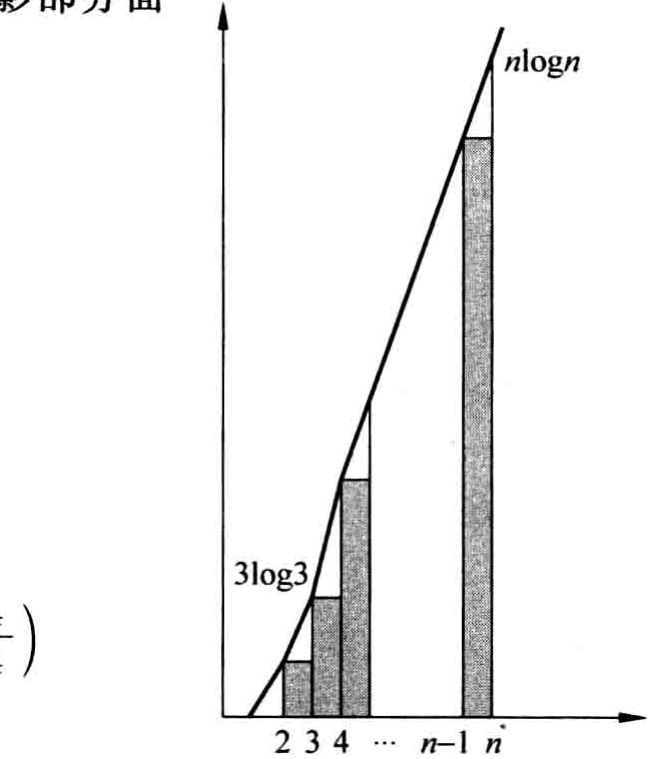
解读:尝试法的逻辑是「先猜一个阶,再比两边最高次项」:设成 cn 时右边多出一个一次项,说明猜小了;设成 cn^2 时右边系数只有 2c/3,说明猜大了;夹在两者之间的 cn\log n 正好两边都是 cn\log n,就定下来了。它不给出精确解,只给出阶,但对算法分析够用。
10.1.5 递推方程与递归算法
递归算法的特点是在算法内部调用自己,分析它的效率往往要借助递推方程.分治是算法设计里一种重要的技术:把原问题拆成若干规模更小的子问题,分别递归求解,再把子问题的解综合成原问题的解.设 a,b 为正整数,n 为问题的输入规模,n/b 为子问题的输入规模,a 为子问题个数,d(n) 为将原问题分解成子问题以及将子问题的解综合得到原问题解的代价.例如对 n 个正整数进行二分归并排序,那么 b=2,a=2,d(n)=n-1.一般情况下有
经过迭代得到
其中
当 d(n)=c 时,代入上式得到
当 d(n)=cn 时,代入上式得到
这些结论可以直接拿来用,例如二分归并排序的递推方程是
其中 a=2,b=2,d(n)=O(n),根据上面的结果有 W(n)=O(n\log n).
从上面的结果可以看出:当 a>b 时,想让 T(n) 的阶降下来,就得减少子问题的个数 a.看下面的例子.
解读:a<b、a=b、a>b 这三种情形,正是分治算法效率的分水岭:子问题个数少于「缩小的倍数」时总代价由最上层主导(O(n)),相等时每一层代价相当、共 \log n 层(O(n\log n)),多于时叶子层爆炸式主导(O(n^{\log_b a}))。想让算法更快,就只能压 a。
例 10.17 设 X,Y 为 n 位二进制数,其中 n=2^k,求 XY.设计关于这个问题的算法,并分析算法用到的位乘次数.
解 最直接的办法是按位相乘,位乘次数显然是 W(n)=O(n^2).
采用分治法,将 X 和 Y 分别划分成 n/2 位长的两个整数.令 X=A2^{n/2}+B,Y=C2^{n/2}+D,那么 A,B,C,D 都是 n/2 位长的整数,不难看出,它们满足
根据这个等式,XY 可以通过 4 个 n/2 规模的子问题运算而得到.这些子问题是 AC,AD,BC,BD.当然还有移位和按位加法等额外的代价.这些额外运算的代价与 n 成线性关系,表示成 cn,其中 c 为某个常数.因此,得到如下递推方程
按照上面的结果,由于 a=4,b=2,因此 W(n)=O(n^{\log_2 4})=O(n^2).遗憾的是使用分治策略的算法与普通乘法算法的工作量一样.提高效率的关键在于减少子问题的个数.
考虑下述变换
AD+BC 的计算现在只需要 3 个子问题就够了:其中只有 (A-B)(D-C) 是新的子问题,而 AC 和 BD 可以直接复用另外 2 个子问题的计算结果.这样就把原来的问题归结为 3 个子问题.代价是加法次数增多,但加法的工作量仍旧是 n 的线性函数 cn,只是这里的 c 比变换前大一些,这个增量不影响 W(n) 的阶.根据算法得到如下递推方程
相当于 a=3,b=2,因此 W(n)=O(n^{\log_2 3})=O(n^{1.59}),这个算法比起普通乘法算法有了明显的改进.
例 10.18 设 a 为实数,n 为正整数且恰好是 2 的幂.下述算法 Power 是计算 a^n 的算法.
Power(a,n)
- if n=1 then return a
- else x \leftarrow Power(a,n/2)
- \qquad return x * x
估计该算法最坏情况下的时间复杂度.
解 该算法先计算 a^{n/2},然后将两个 a^{n/2} 相乘,从而得到 a^n.如果以两个数的相乘作为基本运算,对于给定的 n,设算法 Power 在最坏情况下所做的乘法次数为 T(n).那么 T(n) 比规模减半的子问题计算量 T(n/2) 多 1 次乘法.因此得到下述递推方程:
代入 n=2^k,不断迭代,得到
解读:例 10.17 的改进只做了一件事:把 AD+BC 这个需要两次乘法的组合,换成 (A-B)(D-C)+AC+BD,于是子问题个数从 4 降到 3,阶就从 n^2 掉到 n^{1.59}。而例 10.18 里 T(n)=T(n/2)+1 之所以只出 \log n,是因为每次只留一个子问题,代价沿一条链累加。
再考虑 Fibonacci 数列 1,1,2,3,5,8,\cdots,即 F_0=1,F_1=1,\cdots,F_n=F_{n-1}+F_{n-2}.假设 n=2^k,k 为正整数.若从初值 F_0 和 F_1 出发,用递推公式逐项往后推来求第 n 个 Fibonacci 数的值 F_n,需要做 n-1 次加法.下面考虑另一种算法.
为了下面推导方便,先在数列 \{F_n\} 前面添上一项 0,暂记作 F_{-1},那么 F_1=F_0+F_{-1}.关于 F_n 有下面这个性质:
对 n 归纳.
n=1 显然为真.假设命题对 n 为真,则
算法是这样的:对于给定的 n 计算 \begin{bmatrix}1 & 1\\ 1 & 0\end{bmatrix}^n,那么就得到了矩阵 \begin{bmatrix}F_n & F_{n-1}\\ F_{n-1} & F_{n-2}\end{bmatrix},从而得到了 F_n.可以用 Power 算法计算 \begin{bmatrix}1 & 1\\ 1 & 0\end{bmatrix}^n.两个 2 阶矩阵相乘,为得到矩阵的每个项,需要做 2 次数的乘法,4 个项总计需要 8 次乘法,因此完成整个计算需要用 8\log n 次乘法,这个时间复杂度是 O(\log n),而直接用加法需要 O(n) 次加法.尽管乘法比加法稍微慢一些,但是对于大的 n,显然 Power 算法效率更高.
解读:例 10.19 把「查找」的代价记在比较次数上,T(n)=T((n-1)/2)+1 每递归一次规模大约减半,所以解出 \log(n+1)-1。这里 n=2^k-1 这个取值不是随意的——只有这种规模,减半后才正好还是同形式的规模,递推才能干净地迭代到底。
例 10.19 设 A 是 n 个不等的整数(可以为负)按照递增次序排列的数组,其中 n=2^k-1.已知 A 中恰好有一个 i \in \{1,2,\cdots,n\} 满足 A[i]=i.设计一个复杂度最低的算法找到 i.
解 考虑二分检索算法.令 i=(n+1)/2,算法先比较 A[i] 与 i,如果 A[i]=i,那么算法停止并输出 i.如果 A[i]<i,那么可以判定要找的数 >i,即下面的搜索将在 A[i+1..n] 的范围进行.反之,如果 A[i]>i,那么要找的数 <i,即下面的搜索将在 A[1..i-1] 的范围进行.不管怎样,问题都将归约为规模减半的子问题.假设算法对规模为 n 的输入所做比较次数为 T(n),那么有下述递推方程:
迭代解得
这个算法已经很快,但它是不是同类算法里最快的?这还需要进一步分析.可以证明,在以比较运算作为基本运算的算法类中,它就是所有算法中最快的.
办法是给这一类算法建一棵树模型,称为决策树.设 A 是任意一个找 i 的正确的算法,它的基本运算是比较 A[i] 与 i.从树根开始,按下面的规则构造这棵树:
(1)如果算法的第一步比较 A[i] 与 i,那么将树根标记为 i;
(2)如果 A[i]=i,算法停止,树构造完毕;
(3)如果 A[i]<i,且算法下一步比较 A[j] 与 j,那么将标记结点 j,并将 j 作为 i 的左儿子;
(4)如果 A[i]>i,且算法下一步比较 A[k] 与 k,那么将标记结点 k,并将 k 作为 i 的右儿子.
拿最简单的顺序检索算法做例子:先比较 A[1] 与 1;如果不等,则比较 A[2] 与 2,\cdots,直到找到 A[i]=i 为止.当 n=7 时,顺序检索与二分检索算法的决策树分别给在图 10.5(a) 和 (b) 中.
对于给定的输入,算法从决策树的树根出发,每步比较之后沿一条边进入它的一个儿子所代表的结点,直到某个内结点或者树叶停止.比如在图 10.5(a) 的顺序检
索算法中,如果输入数组 A=\{-5,-4,0,1,5,8,10\},那么算法将从树根沿着这条唯一的路径向下,经过结点 2,3,4,直到结点 5 停止.从结点 1 到 5,路径长度是 4,经过 5 个结点,比较次数是 5.而对于二分检索,算法将从树根 4 经过结点 6 走到结点 5 为止,路径长度为 2,经过 3 个结点,但比较次数是 2.因为根据题目条件,A 中恰好存在 1 个数 A[i]=i,当前面的数都不满足这个条件时,唯一剩下的数 A[5] 一定等于 5,因此 A[5] 与 5 的比较可以省略,即每条路径末端树叶位置的比较可以省略.对于顺序检索算法,最坏的输入要走到结点 7 才能停止,需要做 6 次比较.而二分检索,树中的路径长度不超过 2,至多需要 2 次比较.
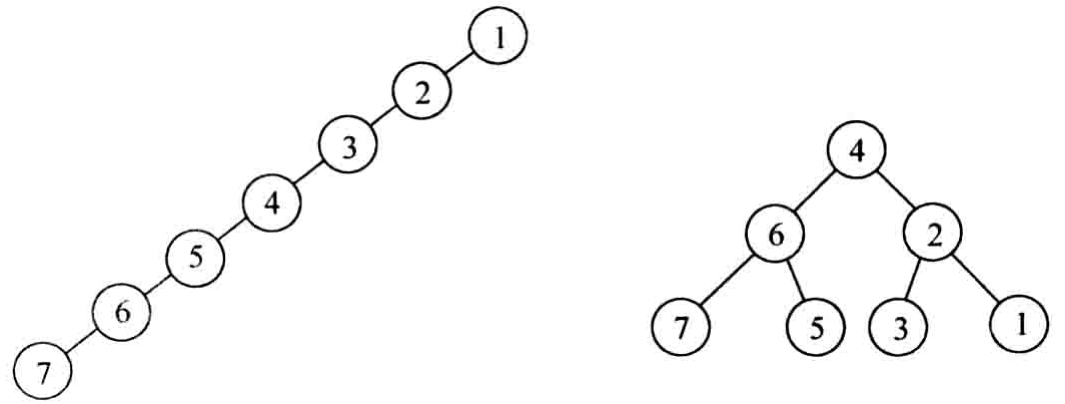
由上述分析不难看出:一棵决策树就代表一个算法;给定输入后,算法从树根出发沿着某一条路径向下,直到某个内结点或者树叶停止.算法在最坏情况下的比较次数等于决策树的树深,也就是它的最长路径的长度.
解读:决策树这一步把「算法」变成了「一棵二叉树」:任何一次比较最多把候选集劈成两支,所以 n 个结点的决策树深度下界是 \lfloor \log(n+1) \rfloor - 1,这也就是比较类算法无法突破的墙。二分检索恰好贴着这堵墙,所以它最优。
这一类里的算法决策树结构各不相同,但都是含有 n 个结点的二叉树.可以用归纳法证明 n 个结点的二叉树的深度 d 至少为 \lfloor \log(n+1) \rfloor - 1,这里的 \lfloor x \rfloor 表示不大于 x 的最大的整数.例如,\lfloor \log 7 \rfloor = 2,\lfloor \log 8 \rfloor = 3.
命题 深度为 d 的二叉树至多含有 2^{d+1}-1 个结点.
d=0,该树只有 1 个结点,而 2^{0+1}-1=1.命题正确.假设对于任意自然数 d,命题为真,考虑深度为 d+1 的二叉树 T,其 d+1 层有 k 片树叶.由于二叉树的构成,每个结点至多 2 个儿子.第 0 层(树根)只有 1 个结点,每层结点数都不超过上一层结点数的 2 倍,因此 d+1 层的结点数不超过 2^{d+1},即 k \leqslant 2^{d+1}.拿掉这 k 片树叶,得到深度为 d 的树 T'.根据归纳假设,树 T' 的结点数 n' 不超过 2^{d+1}-1,因此树 T 的结点数
根据上述命题,有 2^{d+1} \geqslant n+1,即 d \geqslant \lfloor \log(n+1) \rfloor - 1.
对这类算法中的任意一个,当输入规模为 n 时决策树含有 n 个结点,不管树呈现什么结构,其深度至少为 \lfloor \log(n+1) \rfloor - 1.这意味着对于该算法,都存在一个坏的输入,它在这个输入下的计算将沿着这条最长的路径进行,直到最深处的树叶停止,即需要做 \lfloor \log(n+1) \rfloor - 1 次比较.
回顾上面的二分检索算法,在 n=2^k-1 的条件下有
它的最坏情况下的时间复杂度恰好达到该算法类时间复杂度的下界,没有算法能够比它更低,从而证明了二分检索算法是该算法类中效率最高的算法.