本节对应原书 PDF 第 192–197 页。定义、定理、公式、例题及其原解答逐字取自原书;解释性文字为 AI 通俗化改写;标有「解读」的引用块为 AI 补充的额外直觉。
一个有向图 D,如果略去各边的方向后所得无向图为无向树,则称 D 为有向树. 在有向树中,最重要的是根树,它在计算机专业的数据结构、数据库等专业课程中占据极其重要的位置. 本节主要讨论根树及它的应用.
7.2.1 根树及其分类
定义 7.5 一棵非平凡的有向树,如果有一个顶点的入度为 0,其余顶点的入度均为 1,则称此有向树为根树. 在根树中,入度为 0 的顶点称为树根;入度为 1,出度为 0 的顶点称为树叶;入度为 1,出度大于 0 的顶点称为内点,内点和树根统称为分支点.
图 7.9(a) 为一棵根树. v_0 为树根,v_1,v_3,v_5,v_6,v_7 均为树叶,v_2,v_4 为内点,v_0,v_2,v_4 为分支点. 在画根树时,今后总是把树根放在最上方,有向边的方向都向下或向斜下方,有向边的方向均省去,如将图 7.9(a) 画成(b)的样子.
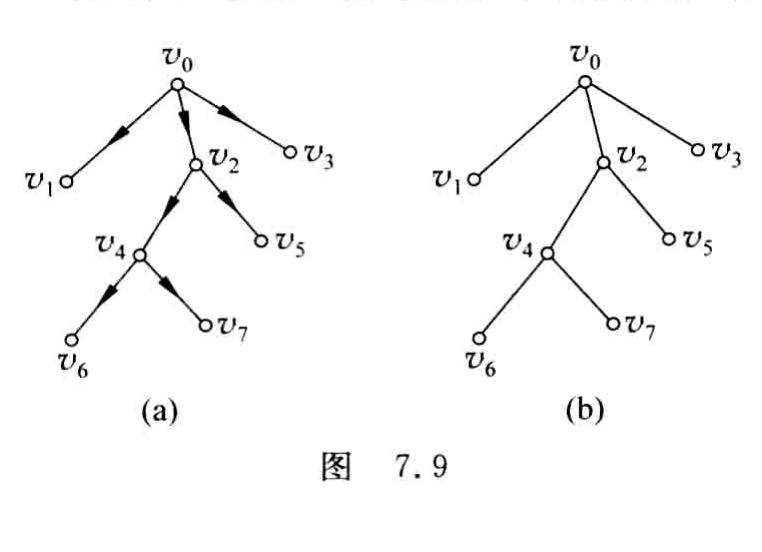
图 7.9
解读:入度为 0 就是「没有父亲」,入度为 1 就是「恰有一个父亲」——这条限制把所有顶点组织成一棵从树根向下生长的家族树。出度为 0 表示「没有儿子」,所以树叶就是末端;出度大于 0 的才是内点。
在根树中,从树根到任一顶点 v 的通路长度称为 v 的层数,记作 l(v),称层数相同的顶点在同一层上. 层数最大顶点的层数称为树高,记 h(T) 为根树 T 的高度. 在图 7.9 所示根树 T 中,树根 v_0 处在第 0 层上,l(v_0)=0,v_1,v_2,v_3 处在第 1 层上,l(v_i)=1,i=1,2,3. v_4,v_5 处在第 2 层上,l(v_j)=2,j=4,5. v_6,v_7 处在第 3 层上,l(v_k)=3,k=6,7. h(T)=3. 有的书上规定,树根的层数为 1,它的下一层顶点的层数为 2,……. 希望读者注意区分.
一棵根树可以看成一棵家族树:
若顶点 a 邻接到顶点 b,则称 b 为 a 的儿子,a 为 b 的父亲;若 b,c 的父亲相同,则称 b,c 为兄弟;若 a\neq d,且 a 可达 d,则称 a 为 d 的祖先,d 为 a 的后代.
在图 7.9 中,v_1,v_2,v_3 是兄弟,它们的父亲是 v_0. v_4,v_5 是兄弟,它们的父亲是 v_2. v_6,v_7 是兄弟,它们的父亲是 v_4. v_0 以外的所有顶点都是 v_0 的后代,v_0 是它们的祖先.
在根树 T 中,设 a 是一个非根顶点,称 a 及其后代导出的子图 T' 为 T 的以 a 为根的根子树.
解读:本节用的层数是从 0 开始数(树根在第 0 层),所以高为 3 的树实际有 4 层。换成「树根在第 1 层」的约定后,同一个 h(T) 数值会差 1,做习题前先确认用的是哪一种。
定义 7.6 如果将根树每一层上的顶点都规定次序,这样的根树称为有序树.
次序可全标在顶点处,也可以全标在边上. 标出的次序不一定是连续的数.
根据根树各分支点有儿子的多少,以及顶点是否排序,可将根树分成若干类.
定义 7.7 设 T 为一棵非平凡的根树. 若 T 的每个分支点至多有 r 个儿子,则称 T 为 r 元树;若 T 的每个分支点都恰有 r 个儿子,则称 T 为 r 元正则树;若 r 元树 T 是有序的,则称 T 为 r 元有序树;若 r 元正则树 T 是有序的,则称 T 是 r 元有序正则树;若 T 是 r 元正则树,且所有树叶的层数均为树高 h(T),则称 T 为 r 元完全正则树;若 T 是 r 元完全正则树,且 T 是有序的,则称 T 为 r 元有序完全正则树.
在所有的 r 元树中,2 元树最重要,2 元树又称为 2 叉树.
下面讨论 2 元树的应用.
解读:定义 7.7 一次性给出 5 个术语,它们层层加码、互不替代:「r 元树」只要求儿子数至多 r;「正则」把它收紧成恰好 r;「有序」额外要求同层顶点有次序;「完全」再要求所有树叶都在最后一层。四个条件可以独立成立,少一条含义就变了。
7.2.2 最优树与哈夫曼算法
定义 7.8 设 2 元树 T 有 t 片树叶 v_1,v_2,\cdots,v_t,权分别为 w_1,w_2,\cdots,w_t,称 W(T)=\sum\limits_{i=1}^{t}w_i l(v_i) 为 T 的权,其中 l(v_i) 是 v_i 的层数. 在所有有 t 片树叶且权分别为 w_1,w_2,\cdots,w_t 的 2 元树中,权最小的 2 元树称为带权 w_1,w_2,\cdots,w_t 的最优 2 元树.
在图 7.10 中所示的 3 棵树 T_1,T_2,T_3 都是权为 1,3,4,5,6 的 2 元树,它们的权分别为:W(T_1)=(1+4+5)\times 2+(3+6)\times 3=47,W(T_2)=3\times 1+4\times 2+5\times 3+(1+6)\times 4=54,W(T_3)=(6+3+5)\times 2+(1+4)\times 3=43.
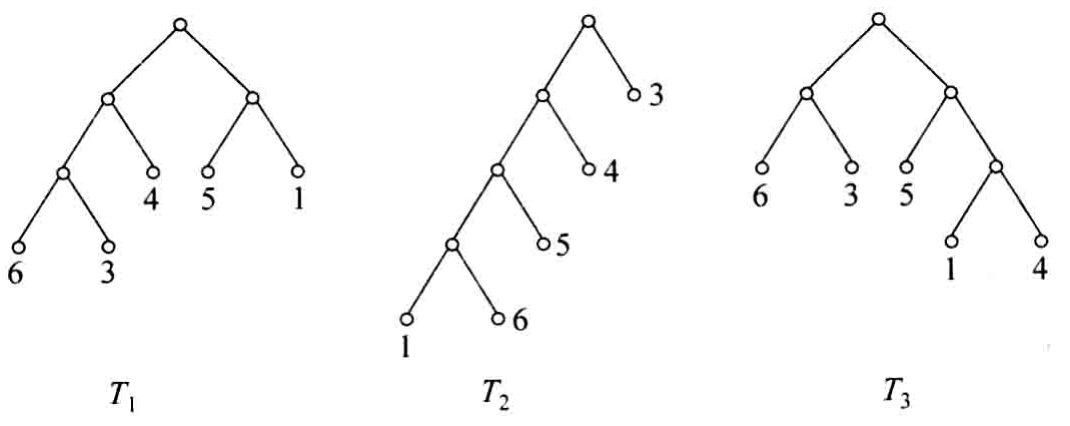
图 7.10
下面给出求最优 2 元树的算法.
Huffman 算法:
给定实数 w_1,w_2,\cdots,w_t.
(1) 作 t 片树叶 v_1,v_2,\cdots,v_t,分别以 w_1,w_2,\cdots,w_t 为权. 令 A=\{v_1,v_2,\cdots,v_t\},i=t+1.
(2) 若 |A|=1,则计算结束.
(3) 在 A 中取 2 个权最小的顶点 v_j,v_k. 引入一个新顶点 v_i,其权为 w_i=w_j+w_k,并将 v_j,v_k 作为 v_i 的儿子.
(4) 令 A=(A-\{v_j,v_k\})\cup\{v_i\},i=i+1,转(2).
W(T) 等于所有分支点的权之和,即 W(T)=w_{t+1}+w_{t+2}+\cdots+w_{2t-1}.
例 7.8 求带权 1,3,4,5,6 的最优 2 元树,并计算它的权 W(T).
解 为了熟悉算法,下面将计算最优树的过程在图 7.11 中分步骤给出. 最优树由图 7.11(d) 给出,它的权 W(T)=42. 根据这个结果,图 7.10 中的 3 棵树都不是最优树.
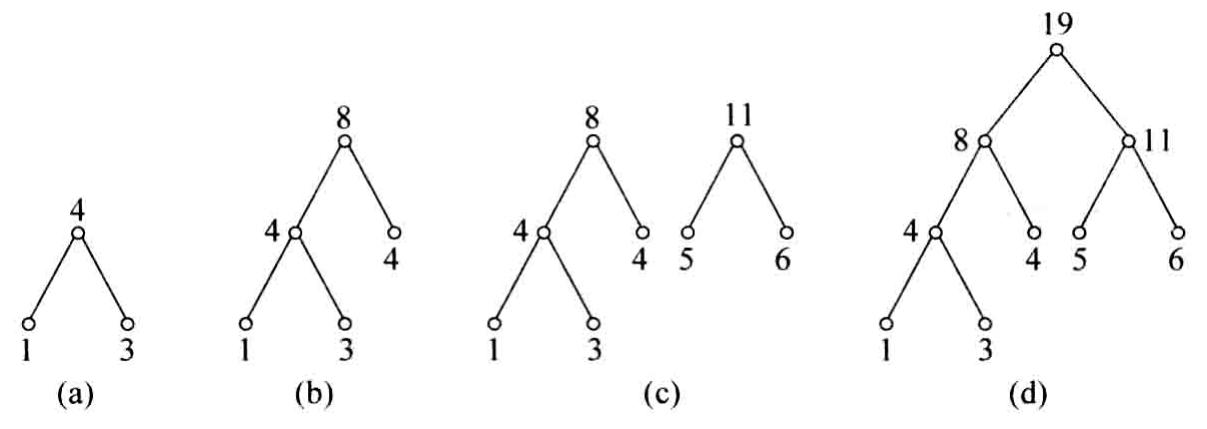
图 7.11
解读:哈夫曼算法的直觉是「让权大的叶子离根近」——每次把当前最小的两个权并成一个新权,等价于让最轻的叶子先沉到最深处。W(T) 等于全部分支点权之和这一条,正是这种「合并」视角的直接推论,也省去了逐叶数层数的麻烦。
哈夫曼树构建演示
7.2.3 最佳前缀码
通信中要用二进制串表示数字、字母和符号,通常都采用等长的编码. 在某些特殊情况下,字符按照一定的频率出现,此时可以用不等长的编码提高效率,使得译文的总长度最短. 但是不等长的编码必须满足一些要求. 例如,如果用 0 表示 A,01 表示 B,10 表示 C,那么 010 既可以表示 AC,又可以表示 BA. 这显然是不行的. 问题就出在 0 和 01 上. 当看到 01…时,不知道是应该把 0 译成 A,还是把 01 译成 B. 为此引入下述前缀码的概念.
定义 7.9 设 \alpha_1\alpha_2\cdots\alpha_{n-1}\alpha_n 为长度为 n 的符号串,称其子串 \alpha_1\alpha_2\cdots\alpha_i(0\leqslant i\leqslant n) 为该符号串的前缀.
设 A=\{\beta_1,\beta_2,\cdots,\beta_m\} 为一个符号串集合. 若对于任意的 \beta_i,\beta_j\in A,i\neq j,\beta_i,\beta_j 互不为前缀,则称 A 为前缀码. 若符号串 \beta_i(i=1,2,\cdots,m) 中只出现 0,1 两个符号,则称 A 为 2 元前缀码.
例如,\{1,01,001,000\},\{00,10,11,011,0100,0101\} 都是前缀码. 而 \{1,01,111,1100\} 不是前缀码,因为 1 是 111 和 1100 的前缀.
可用 2 元树产生 2 元前缀码. 给定一棵 2 元树 T,设它有 t 片树叶. 设 v 为 T 的一个分支点,则 v 至少有一个儿子,至多有两个儿子. 若 v 有两个儿子,在由 v 引出的两条边上,左边的标上 0,右边的标上 1. 若 v 只有一个儿子,在由 v 引出的边上可标上 0,也可标上 1. 设 v_i 是 T 的任意一片树叶,从树根到 v_i 的通路上各边的标号组成的 0,1 符号串放在 v_i 处,t 片树叶处的 t 个符号串组成的集合为一个 2 元前缀码. 这是因为 v_i 处的符号串的前缀是树根到 v_i 的通路中从树根开始的一段上的 0,1 串,它不可能与其余树叶处的符号串相同. 正则 2 元树产生的 2 元前缀码是唯一的. 但是,非正则 2 元树,由于只有一个儿子的分支点的边上可以标 0,也可以标 1,所以它产生的前缀码不是唯一的.
图 7.12 所示的 2 元树产生的前缀码为 \{00,10,11,010,0110,0111\}.
设 m 个字符在通信中出现的频率分别为 p_1,p_2,\cdots,p_m,使用 2 元前缀码 \beta_1,\beta_2,\cdots,\beta_m 表示这 m 个字符. 记 l_i=|\beta_i|,w_i=100p_i,1\leqslant i\leqslant m,那么传输 100 个字符所需的平均码长为 l=\sum\limits_{i=1}^{m}l_iw_i. 称平均码长 l 最短的 2 元前缀码为最佳前缀码. 现在构造一棵 2 元树生成前缀码 \beta_1,\beta_2,\cdots,\beta_m,注意到 \beta_i 所在树叶的层数恰好为 l_i,因而权为 w_1,w_2,\cdots,w_m 的最优 2 元树生成的前缀码就是最佳前缀码.
例 7.9 设通信中八进制数字出现的频率如下:
求传输它们的最佳前缀码.
解 用 100 乘各频率,并由小到大排序,得 w_1=5,w_2=5,w_3=5,w_4=10,w_5=10,w_6=15,w_7=20,w_8=30 为 8 个权(记住它们与数字的对应关系). 用 Huffman 算法求得的最优 2 元树如图 7.13 所示.
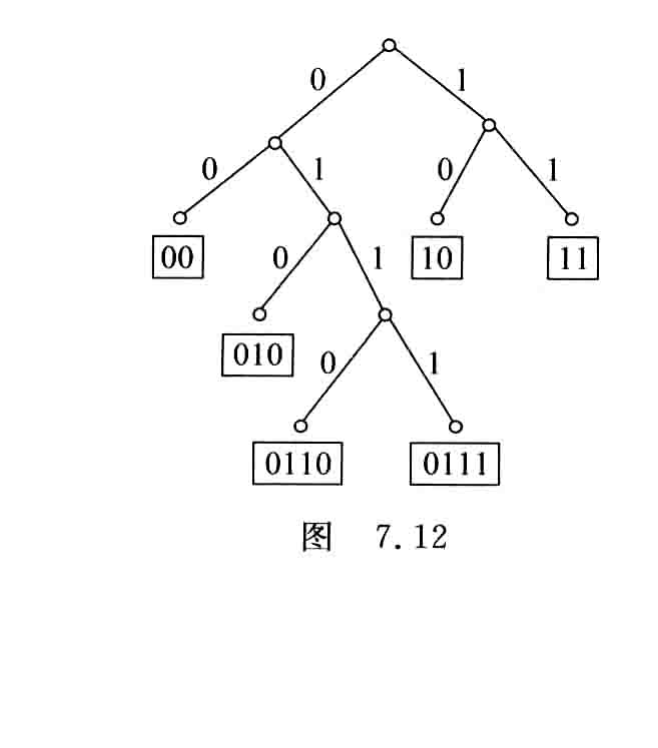
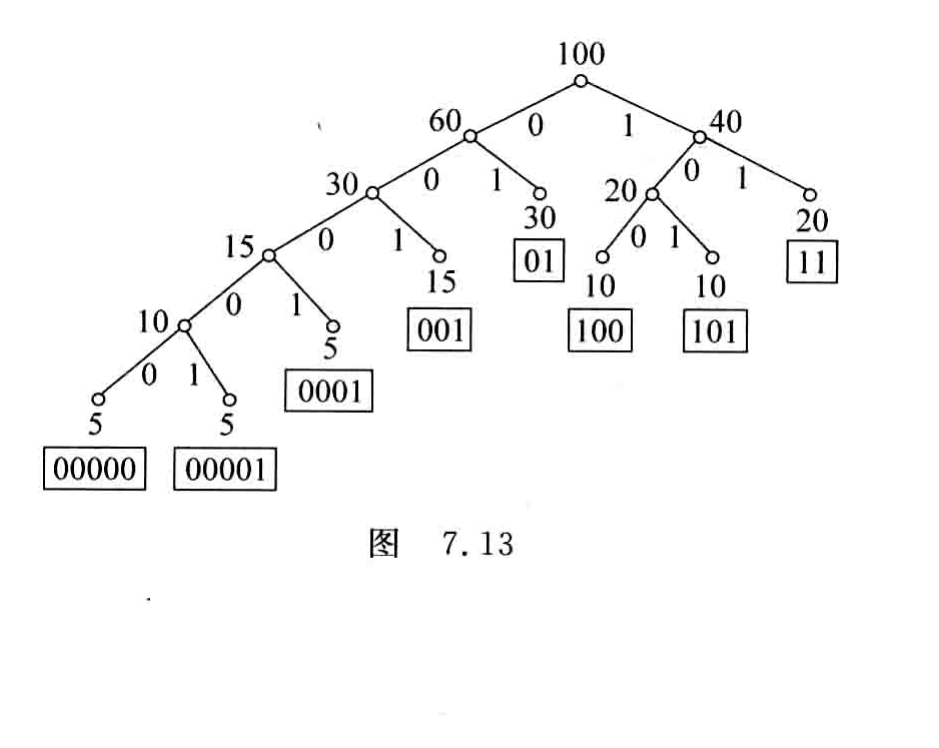
图 7.12 图 7.13
图中方框中的 8 个码子组成的集合是最佳前缀码. 8 个码子对应的数字如下:
用完全等长的码子传输八进制数字,如 000 传 0,001 传 1,……,要传输按例 7.10 中比例出现的八进制数字 10 000 个,所用二进制数位为 30 000 个,这与数字出现的频率是无关的. 但若用最佳前缀码传输它们,所需二进制数位为
比用长为 3 的等长码子传输节省二进制数位 2500 个,提高效率 2500/30\ 000\approx 8.3\%.
解读:前缀码保证「译码不用回头猜」——读到一个码子立刻能定字符,因为没有任何码子是另一个的开头。把码子放在树叶上、把 0/1 标在分支上,这正好和「树叶的层数 = 码长」对上,于是「平均码长最短」就等价于「带权最优 2 元树」,两个问题合成一个。
7.2.4 根树的周游及其应用
对于一棵根树的每个顶点都访问一次且仅访问一次称为行遍或周游一棵树.
对于 2 元有序正则树有以下 3 种周游或行遍方法:
(1) 中序行遍法 其访问次序为:左子树,树根,右子树.
(2) 前序行遍法 其访问次序为:树根,左子树,右子树.
(3) 后序行遍法 其访问次序为:左子树,右子树,树根.
对于图 7.14 所示根树按中序、前序、后序行遍的周游结果分别为
式中 \underline{v} 表示 v 为根子树的根.
利用 2 元有序树可以表达算式,然后根据不同的访问方法得到算式的不同表示和相应的算法.
用 2 元有序树存放算式时,把运算符放在分支点上,变量和常量放在树叶上,每个分支点上的运算符的运算对象是以该分支点的儿子为树根的子树(树叶)存放的子式(变量或常量).
例如,存放算式
的 2 元有序树如图 7.15 所示. 访问这棵树,中序行遍法访问结果为
前序行遍法访问结果为
后序行遍法访问结果为
对于中序行遍法的访问结果,利用四则运算的规则,可去掉一些括号,得到
正是原式,所以中序行遍法访问,其结果是还原算式.
对于前序行遍法访问结果,将全部括号去掉,得如下结果:
对这个表达式规定,从右到左,每个运算符对它后面紧邻的两个数(对于一元运算符是一个数)进行运算,其计算结果恰好是算式的计算结果. 因为运算符在运算对象的前面,因而称此种表示法为前缀符号法,也称为波兰符号法.
对于后序行遍法的访问结果,省去全部括号,得结果为
对这个表达式规定,从左到右,每个运算符对它前面紧邻的两个数(对于一元运算符是一个数)进行运算,其计算结果也恰好是算式的计算结果. 因为运算符在参加运算对象的后面,所以称此种表示法为后缀符号法,也称为逆波兰符号法.
解读:三种行遍只是「什么时候读根」的顺序差别,但落在算式上后果完全不同:中序得到人读的算式,前序得到波兰式,后序得到逆波兰式。波兰式从右往左、逆波兰式从左往右扫描,都能不做括号消歧地算完,这正是编译器求值栈的基础。