本节对应原书 PDF 第 307–313 页。定义、公式、算法、例题及其原解答逐字取自原书;解释性文字为 AI 通俗化改写;标有「解读」的引用块为 AI 补充的额外直觉。
算法的平均复杂度分析是相对于输入的概率分布而言的,因此为了对算法进行平均复杂度分析必须首先假设输入服从某种分布,下面通过对排序算法和散列表检索算法的平均复杂度分析来加以说明.
解读:平均复杂度与最坏复杂度的区别在于对"输入"的态度。最坏复杂度对所有输入取上界,平均复杂度则要先给输入规定一个概率分布再求期望——分布换了,结论可能完全不同,所以"平均"二字的含义必须连同假设一起记。
13.3.1 排序算法
快速排序算法是最常用的一种排序算法,它的基本思想是:设输入 A[1..n],取 A 的一个元素 x(如 A 的第 n 个元素,x=A[n]),称作轴值. 以轴值 x 为标准把 A 划分成 2 个数组 A_1 和 A_2,其中 A_1 中的数都小于等于 x,而 A_2 中的数都大于 x. A 的排列顺序为 A_1,x,A_2,然后分别对 A_1 和 A_2 排序. 算法描述如下.
算法 13.6 快速排序算法.
Quicksort(A,p,r)
- if p\geqslant r then return A
- x\leftarrow A[r] // 取 A[r] 作为轴值
- i\leftarrow p-1
- for j\leftarrow p to r-1 do
- \quad if A[j]\leqslant x then i\leftarrow i+1,交换 A[i] 与 A[j]
- 交换 A[i+1] 与 A[r]
// 把 A[p..r] 分成 2 组 A[p..i] 和 A[i+2..r],轴值 x 置于 A[i+1]
- Quicksort(A,p,i)
- Quicksort(A,i+2,r)
算法 13.6 是递归结构,计算时调用 Quicksort(A,1,n). 图 13.1 给出它的一次分组计算过程. 快速排序算法的计算时间与输入数据的排列有关,最坏的情况是输入的数据几乎是排好序的,每一次划分的结果差不多总是把几乎所有的数分到一组中,计算时间为 O(n^2). 最好的情况是每次都划分成 2 个大小差不多的数组,计算时间为 O(n\log n).
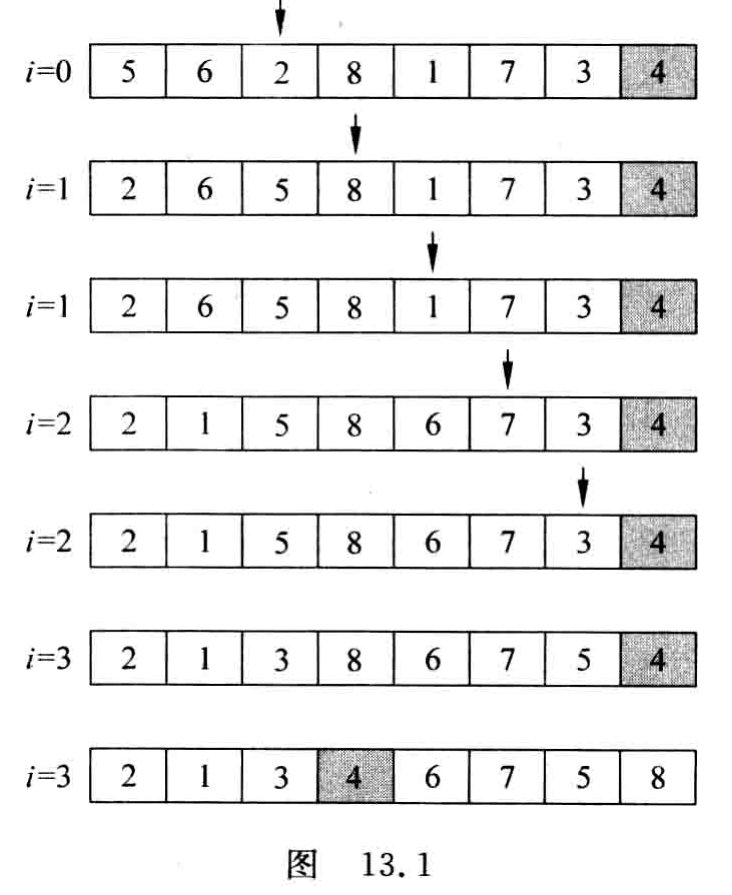
解读:算法第 6 步之后轴值落在下标 i+1,故递归的两段是 A[p..i] 与 A[i+2..r]——轴值本身已经归位,不再参与递归,这就是左段右界写成 i、右段左界写成 i+2 的原因。
下面来分析它的平均计算时间. 快速排序算法是比较排序算法的一种,仅使用比较运算来确定 2 个数的相对位置,当输入的规模固定时,算法的运行时间仅与输入数据的排列顺序有关,而与数的大小无关,因此只需要对输入数据的排列进行讨论,即把输入看作一个排列. 不妨设输入的 n 个数是不相同的,用 \pi_n 表示 n 个数的排列,\pi_n(i) 表示 \pi_n 的第 i 个数. 假设输入服从均匀分布,即对每一个排列 \pi_n,P(\pi_n)=\frac{1}{n!},记输入为 \pi_n 时,算法的计算时间为 T(\pi_n),输入规模 n 时的平均计算时间为 T_n,则有
式中 \sum\limits_{\pi_n} 表示对所有的排列 \pi_n 求和.
对输入 \pi_n,设轴值 x 是第 i 个小的数,\pi_n 被划分成 \pi_{i-1} 和 \pi_{n-i},于是有
而
其中 \sum\limits_{*} 表示对 n-1 中取 n-i 的所有排列求和. 同理
从而
又 T_0=0,由例 10.16 得到
解读:这一步的关键是把"对 n! 个排列求和"换成了"对划分位置 i 求和"。固定 i 后,左段有 \binom{n-1}{n-i} 种选法、右段有 (n-i)! 种排列,凑出的系数恰好让 n! 约掉,于是得到只含 T_{i-1} 的递推式。
下面讨论桶排序算法,在输入数据服从 [0,1) 上均匀分布的假设下,它具有线性平均时间复杂度.
设输入 A[1..n] 中的 n 个数都服从 [0,1) 上的均匀分布且相互独立,算法的基本思想是把 [0,1) n 等分,把每个小区间 \left[\dfrac{i}{n},\dfrac{i+1}{n}\right) 叫做一个桶,落在桶内的数据记作 B[i],0\leqslant i\leqslant n-1. 先分别排序每个桶内的数据,然后按 B[0],B[1],\cdots,B[n-1] 的顺序排列所有的数据. 由于输入数据服从 [0,1) 上的均匀分布且相互独立,直观上每个桶内的数据都不会多,主要工作量是把数据分配到各个桶内,这只需要 O(n) 时间.
算法描述如下,其中辅助数组 B[0..n-1] 的每一个元素是一个链表,用来存放一个桶内的数据.
算法 13.7 桶排序算法.
Bucketsort(A)
- n\leftarrow|A|
- for i\leftarrow 1 to n do
- \quad 把 A[i] 插入表 B[\lfloor nA[i]\rfloor]
- for i\leftarrow 0 to n-1 do
- \quad 用插入排序算法对表 B[i] 进行排序
- 依次连接表 B[0],B[1],\cdots,B[n-1]
记算法对输入 A 的计算时间为 T(A),A 被分成 n 个桶,设桶 B[i] 中有 m_i 个数,0\leqslant i\leqslant n-1,m_0+m_1+\cdots+m_{n-1}=n. 除步骤⑤外,所有运算时间为 O(n),而插入排序算法最坏情况的时间复杂度是 O(n^2). 于是,
平均计算时间为
根据假设,对每一个 0\leqslant i\leqslant n-1,每个数落入桶 B[i] 内的概率为 \frac{1}{n} 且相互独立,故桶 B[i] 内的数 m_i\sim B\left(n,\dfrac{1}{n}\right),E(m_i)=1,D(m_i)=1-\dfrac{1}{n}. 由式(12.1),得
代入上式,得到桶排序算法的平均时间复杂度
解读:桶排序之所以能突破比较排序的 O(n\log n) 下界,是因为它不靠两两比较定位,而是用输入值本身当"地址"直接投放;代价是必须先假定输入在 [0,1) 上均匀分布。
13.3.2 散列表的检索和插入
散列表是一种常用的数据结构,具有高效检索和插入的优点. 对记录按关键词储存,设关键词的全域为 U,通常 U 是很大的,而实际使用的关键词数要小得多. 如果准备 |U| 大的储存空间,不仅是很大的浪费,甚至是不可能的. 例如,某高校用学号作为学生的关键词,学号是一个 7 位数,共有 1000 万个,而实际在校学生不足 2 万人. 为了储存学生的信息,没有必要使用能够储存 1000 万条记录的计算机.
设数组 T[0..m-1],构造函数 h:U\to\{0,1,\cdots,m-1\},把关键词 K 存入 T[h(K)](实际上应该是存入关键词 K 和它的记录),函数 h 称作散列函数,h(K) 称作关键词 K 的散列值. 散列函数 h 通常不是单射的,当 h(K_1)=h(K_2)(K_1\neq K_2)时,就要发生冲突. 有多种解决冲突的方案. 下面对两种常用方案的平均复杂度进行分析.
1. 链接法
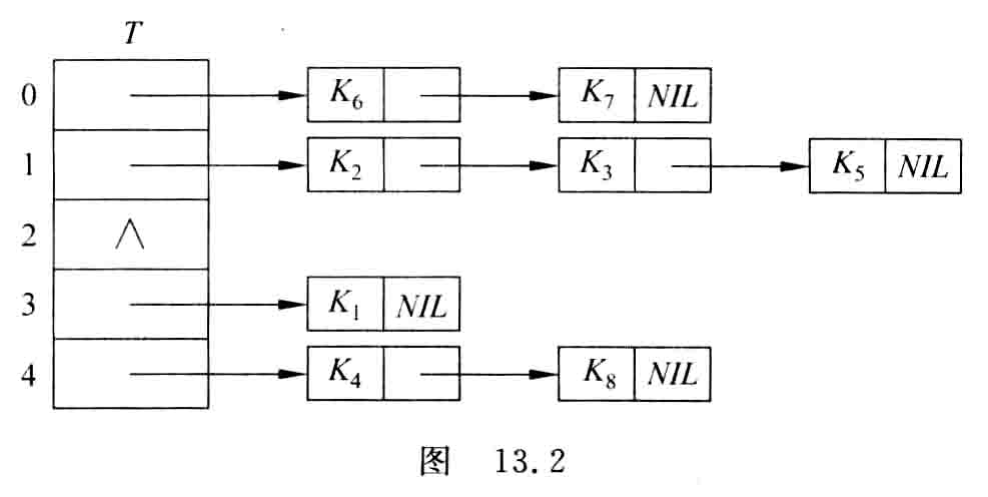
链接法把散列值相同的关键词组成一个链表,以此来解决问题. 散列表 T[0..m-1] 的每一个元素对应一个链表,关键词 K 存放在链表 T[h(K)] 中,如图 13.2 所示. 链式散列表的搜索和插入算法描述如下,数组 DATA[1..N] 存放关键词,NEXT[1..N] 存放链表的指针,n 是已存入的关键词数. 任给关键词 K,如果 K 已在 DATA 中,则要查找到存放 K 的位置,即找到 i 使 DATA[i]=K;如果 K 不在 DATA 中,则要把 K 插入 DATA.
算法 13.8 链式散列表的检索和插入算法.
Chained Hash(K,n)
- i\leftarrow h(K)
- if T[i]=Λ then n\leftarrow n+1,T[i]\leftarrow n,转⑧ // 建立一个新的链表
- i\leftarrow T[i]
- if i=N+1 then 溢出,结束 // 表已满,查找失败
- if DATA[i]=K then 输出 i,结束 // 查找成功
- if NEXT[i]=NIL then n\leftarrow n+1,NEXT[i]\leftarrow n,转⑧ // 插入 K
- i\leftarrow NEXT[i],转④
- if n\leqslant N then DATA[n]\leftarrow K,NEXT[n]\leftarrow NIL
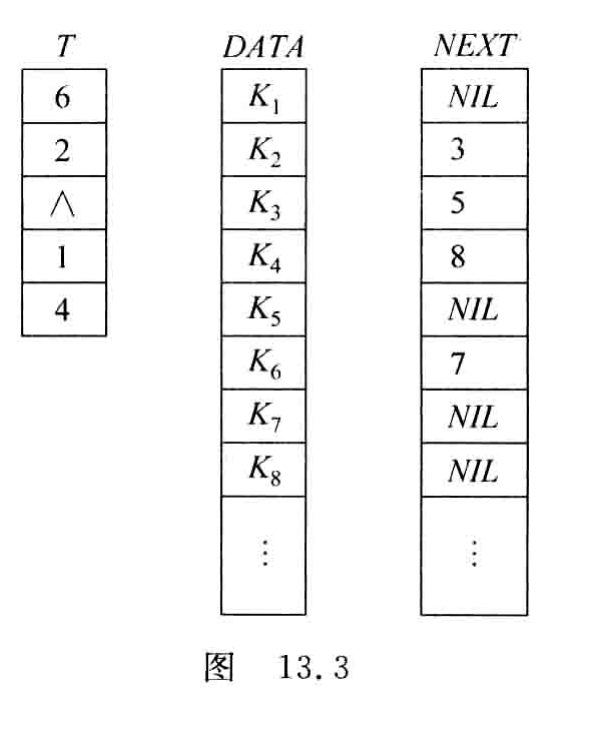
用算法 13.8 将图 13.2 中的 8 个关键词插入链式散列表的结果如图 13.3 所示.
链式散列表的检索和插入的运行时间取决于待插入(检索)的关键码 K 将要插入的链表 T[h(K)] 的长度(在链表 T[h(K)] 的位置),这与数据服从的分布和散列函数 h 有关. 在数据结构和算法设计的书中有对散列函数的专门论述. 为了分析算法 13.8 的平均复杂度,下面考虑最理想的情况,假设对每一个关键码 K,h(K) 服从 \{0,1,\cdots,m-1\} 上的均匀分布,即 P\{h(K)=i\}=\frac{1}{m},0\leqslant i\leqslant m-1,并且关键码的取值是相互独立的,称这样的散列函数为简单均匀散列函数.
解读:算法 13.8 第 2 步里的 Λ 是原书表示空指针(空表)的记号,不是逻辑联结词,读代码时不要与 \wedge 混为一谈。
设关键码 K 不在 DATA 中,除循环步骤④~⑦外,其余步骤只需常数时间. 设循环次数为 M,M 等于比较 DATA[i]=K 的次数. 令
比较 K 与 DATA[i] 当且仅当 h(K)=h(DATA[i]),由假设,X_1,X_2,\cdots,X_n 相互独立且都服从参数 \frac{1}{m} 的 0-1 分布,而
故 M\sim B\left(n,\frac{1}{m}\right),得 E(M)=\frac{n}{m}. 得证在简单均匀散列函数的假设下,算法 13.8 插入的平均时间复杂度为
其中 \alpha=\frac{n}{m} 称作负载因子.
现在考虑搜索的平均时间复杂度,设 K 已在 DATA 中,假设 K 等可能地为已存入的 n 个关键码中的每一个. 注意到,当 K=K_i 时,查找到 K 的时间与插入 K_i 的时间基本相同,只相差一个常数. 而插入第 i 个关键码 K_i 时,已存入 i-1 个关键码,平均时间为 T_{i-1}=O\left(1+\frac{i-1}{m}\right). 根据习题 12.38 得到搜索的平均时间复杂度为
2. 开地址法
开地址法与链接法不同,把关键码全部存放在散列表 T[0..m-1] 中,而不需要指针. 它对每一个关键码 K 产生一个搜索序列 h[K,0],h[K,1],\cdots,h[K,m-1],在表 T[0..m-1] 中沿着这个搜索序列提供的地址搜索,直至找到待检索的关键码 K,或找到一个空单元将 K 插入为止. 序列 h[K,0],h[K,1],\cdots,h[K,m-1] 是 0,1,\cdots,m-1 的一个排列. 开地址散列表的搜索和插入算法描述如下,这里假设所有的关键码不等于 0,计算开始时表 T[0..m-1] 的所有元素置 0.
算法 13.9 开地址散列表的检索和插入算法.
Open Address Hash(T,K)
- for i\leftarrow 0 to m-1 do
- \quad j\leftarrow h(K,i)
- \quad if T[j]=K then 输出 j,结束 // 查找成功
- \quad if T[j]=0 then T[j]\leftarrow K,结束 // 插入 K
- 溢出 // 表已满,查找失败
为了分析算法 13.9 的平均复杂度,同样也考虑理想的情况,假设搜索序列服从均匀分布,即对每一个关键码 K,序列 h[K,0],h[K,1],\cdots,h[K,m-1] 为 0,1,\cdots,m-1 的每一个排列的可能性相等.
当关键码 K 不在 T 中时,设算法 13.9 插入 K 所用的循环次数为 M. 对任意的 1\leqslant i\leqslant n,M\geqslant i 当且仅当 T[h(K,0)],T[h(K,1)],\cdots,T[h(K,i-2)] 已被占用. 满足这个条件的搜索序列的数目是 (i-1)!\binom{n}{i-1}(m-i+1)!. 根据假设,当 1\leqslant i\leqslant n 时,
当 i>n 时,显然 P\{M\geqslant i\}=0. 于是,由习题 12.37,
从而,得证在搜索序列服从均匀分布的假设下,算法 13.9 插入运算的平均时间复杂度为
其中负载因子 \alpha=\frac{n}{m},此时必有 \alpha<1.
和前面一样,当 K 已在 T 中时,假设 K 等可能为表 T 中 n 个关键码中的每一个,搜索的平均时间复杂度为
而
于是,得到
最简单的开地址法是线性搜索法,它的搜索序列是
其中 h_1:U\to\{0,1,\cdots,m-1\} 是一个散列函数,c 是一个与 m 互素的正整数. c 与 m 互素可以保证序列 h(K,0),h(K,1),\cdots,h(K,m-1) 是 0,1,\cdots,m-1 的一个排列.
双散列函数法是最好的开地址法,它有 2 个散列函数 h_1 和 h_2,其中 h_2(K) 与 m 互素,搜索序列为
搜索序列服从均匀分布是理想的假设,线性搜索法只能产生 m 个不同的搜索序列,不可能满足这个理想的假设. 双散列函数法能产生 m^2 个不同的搜索序列,虽然它也不满足均匀分布的假设,但是实践表明,当 h_1 和 h_2 取得比较好时,其性能很接近这种理想的情况.
解读:链接法在负载因子 \alpha 可以大于 1 时仍能工作,开地址法却要求 \alpha<1——因为关键码全部直接住在表里,表满了就再也插不进新元素。\alpha\to 1 时 \frac{1}{1-\alpha} 发散,正对应这种"表将满而未满"时的急剧退化。